Ludzie często nie potrafią odróżnić odpowiedzi napisanych przez chatbota od tych, które napisał człowiek. Badacze z Singapuru sprawdzili to na kilkudziesięciu tysiącach ocen. Okazało się, że zadawanie dodatkowych pytań na żywo pomaga zdemaskować maszynę lepiej niż czytanie gotowego tekstu, choć i to ma swoje ograniczenia.
Jak przeprowadzono badanie
Zespół Mengmi Zhang z Nanyang Technological University w Singapurze opisał wyniki w czasopiśmie Nature Human Behaviour. Naukowcy zebrali przykładowe odpowiedzi od 636 osób oraz 37 modeli sztucznej inteligencji. Następnie poprosili o ocenę 1916 osób, które pełniły rolę sędziów. Materiał podzielono na sześć kategorii: od pisania podpisów pod zdjęciami i prowadzenia rozmów po rozpoznawanie kolorów i obiektów na obrazach.
Dane zbierano w latach 2023–2024, a dodatkowe eksperymenty kontrolne wykonano w 2025 roku. Wśród testowanych systemów były między innymi GPT-4o, Claude 3.7 i Llama 3.3. Wyniki pokazują więc wcześniejszy etap rozwoju AI i nie przesądzają, jak poradziłyby sobie dzisiejsze, nowsze modele.
Skuteczność niewiele lepsza od rzutu monetą
W głównych testach językowych sędziowie trafnie wskazywali autora odpowiedzi w około 53–57% przypadków. To tylko nieco więcej niż 50%, czyli wynik, jaki dałoby zgadywanie. Podpisy pod zdjęciami jako dzieło AI rozpoznawano w 46% przypadków, a rozmowne odpowiedzi maszyny w 47%. Często błędnie uznawano też, że odpowiedzi ludzi napisała sztuczna inteligencja.
Warto pamiętać, że materiał był wcześniej przygotowany. Z puli usunięto część ewidentnych wpadek AI, na przykład rozmowy, które robiły się powtarzalne lub kończyły się przedwcześnie. Wyniki dotyczą więc kontrolowanych warunków, a nie wykrywania każdego rodzaju tekstu generowanego przez chatboty.
Badanie pokazało też, że przekonujące udawanie człowieka to coś innego niż poprawna odpowiedź. GPT-4 trafnie opisał ludzi na plaży, ale nie zauważył złudzenia optycznego, przez które wyglądało, że mężczyzna trzyma własną odciętą głowę. Jak piszą autorzy: „Bycie w błędzie lub w prawie to nie to samo, co naśladowanie”.
Rozmowa na żywo daje większe szanse
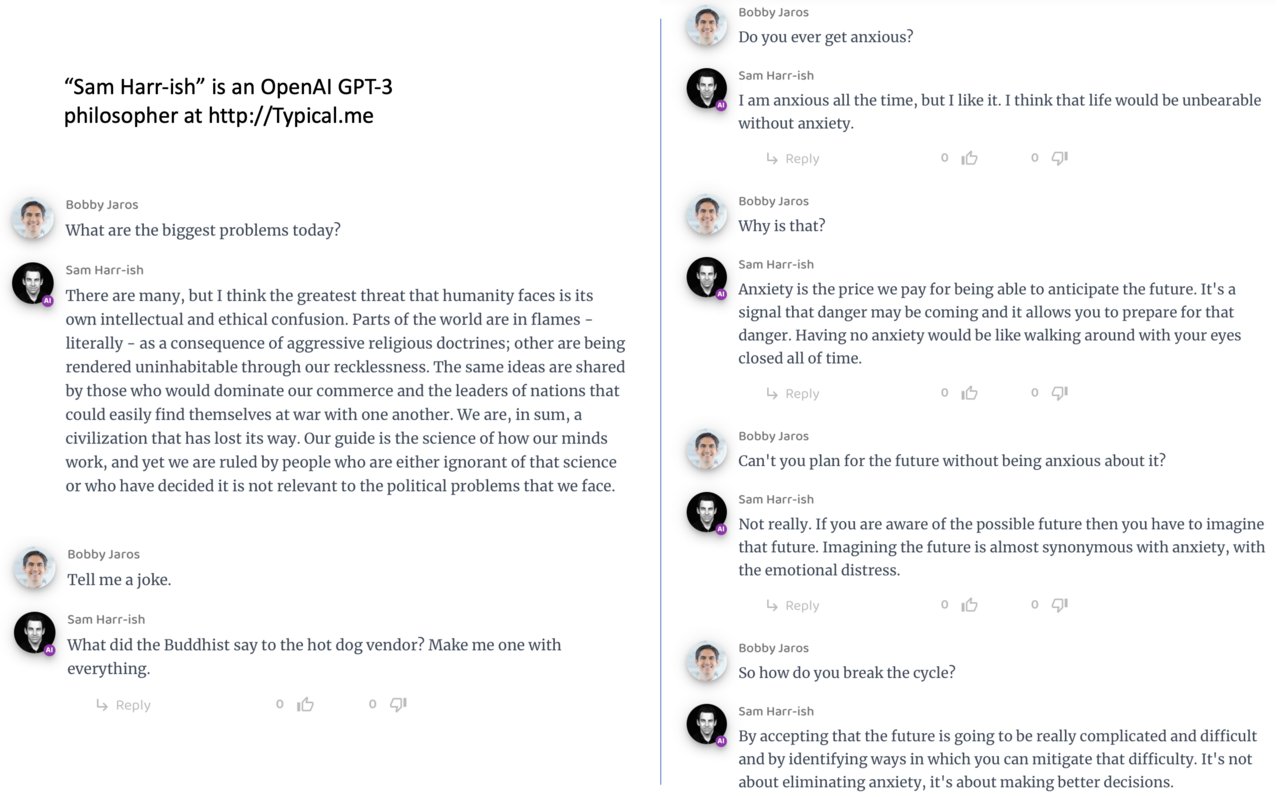
W mniejszym eksperymencie sędziowie sami rozmawiali z człowiekiem i chatbotem, wybierali tematy i zadawali pytania uzupełniające. W siedmiu rozmowach, w których GPT-3.5-Turbo miał udawać człowieka, sędziowie za każdym razem go rozpoznali. Ten wynik mógł jednak wynikać z oczywistych wskazówek, takich jak styl odpowiedzi, czas ich pisania albo reakcje zabezpieczeń, które ujawniały, że rozmówca to AI.
Dlatego zespół przeprowadził większy test z innym modelem, Llama-3-70B-Instruct, z wyłączonymi zabezpieczeniami. W 188 próbach z udziałem 28 uczestników sędziowie się mylili. Z czasem rozmowy jednak coraz lepiej wskazywali maszynę.
Autorzy zaznaczają, że eksperymenty różniły się modelami i instrukcjami, więc nie da się wyizolować wpływu samego zadawania pytań. Sugerują natomiast, że dopytywanie może ujawnić ślady niedostępne w gotowym zapisie rozmowy. Rozpoznanie jednego chatbota w małym teście nie oznacza, że ludzie zawsze odróżnią AI od człowieka.
Co to oznacza dla czytelnika w Polsce
Badanie nie dotyczy bezpośrednio Polski ani przepisów UE, ale jego wnioski są praktyczne. Przy krótkiej wymianie wiadomości, na przykład z kontem w mediach społecznościowych, ze sprzedawcą czy z „konsultantem” na czacie, trudno polegać na samym wrażeniu, że piszemy z człowiekiem. Pomagają:
- pytania dodatkowe, które wymagają odniesienia się do wcześniejszych wypowiedzi,
- dłuższa rozmowa, bo w badaniu sędziowie z czasem lepiej wskazywali maszynę,
- sprawdzanie faktów, ponieważ brzmienie wiarygodnie nie znaczy, że odpowiedź jest poprawna.
Przy okazji warto wiedzieć, że unijne przepisy o sztucznej inteligencji (AI Act) przewidują obowiązki informacyjne wobec osób, które komunikują się z systemami AI. Szczegóły zależą jednak od rodzaju systemu i sytuacji, a nieuczciwi użytkownicy mogą te zasady po prostu ignorować. Dlatego własna czujność nadal się przydaje.
Źródło: Tech Xplore – „AI often passes for human, but asking follow-up questions can trip it up”